闭环空地协同VLA评估套件
摘要
近期的空中视觉-语言-动作(VLA)模型在单架无人机(UAV)任务中展现出了良好的能力,例如追踪移动物体以及导航至语言指定的标志性地点。然而,尚不清楚这些能力能否迁移到空地协同场景中——在该场景下,无人机与无人地面车辆(UGV)必须在一个共享的闭环物理世界中协同行动。我们利用 CARLA-AIR 这一单进程空地协同评估环境对此进行了研究;该环境将 CARLA 和 AirSim 统一整合在同一个虚幻引擎(Unreal Engine)运行时中。通过共享世界状态、物理仿真步长(physics tick)和感知流水线,CARLA-AIR 实现了物理一致的无人机-UGV 交互,并支持对仿真时间戳对齐及有效协同延迟的精确测量。我们利用 CARLA-AIR 评估了具有代表性的空中 VLA 及规划基线模型,测试任务包括两个互补的诊断场景:移动平台着陆和遮挡恢复护航。结果表明,尽管当前的空中 VLA 模型通常能够追踪或跟随地面伙伴,却难以将这种单智能体能力转化为稳定的协同行为。“状态提示”(state prompting)带来的收益有限,而简单的双向交互往往无法持续提升性能,甚至可能放大大多数基线模型的误差。这些发现表明,在现有的基于文本提示的交互界面下,实现零样本(zero-shot)空地协同 VLA 需要在当前范式之外引入三个关键要素:明确的伙伴状态映射(partner-state grounding)、低延迟的动作协同以及团队层面的目标对齐。
介绍
在城市搜救、自主物流、巡检及智能交通等领域,空地协同正成为具身智能的一项重要能力 1。无人机(UAV)能够提供广域的空中感知,而无人地面车辆(UGV)则能执行地面作业并承载更重的载荷 2。从原理上讲,这两种平台具有高度的互补性;然而在实际应用中,要将这种互补性转化为真正的协同,则要求智能体在物理世界的闭环中实现状态共享、行动协调以及相互响应 3。
近期的空中视觉-语言-动作(Vision-Language-Action, VLA)模型提供了一个极具吸引力的起点。它们能够根据语言指令行事,追踪地面移动目标,并利用机载观测信息向视觉目标导航 4 5 6 7。这些能力构成了空地协同中有用功能的重要组成部分。
这就引出了一个核心问题:单架无人机(UAV)的视觉定位与建图(VLA)能力能否自然地迁移到无人机与无人地面车辆(UGV)的协同行为中?
我们认为,这一问题在很大程度上仍未得到解答。现有的空地数据集 8 主要侧重于评估离线感知能力,而现有的交互式仿真器 9 往往依赖于基于桥接(bridge-based)或多进程的架构,且各组件拥有独立的时钟。这种设定使得难以准确衡量:某个智能体的信号是否真正改善了协作伙伴的实时行为,抑或观察到的性能提升或失效,部分源于评估平台自身引入的时钟不匹配与通信延迟。要对协作式视觉-语言-动作(VLA)模型进行可靠评估,必须具备共享的物理世界、闭环交互机制以及可度量的端到端协作延迟。
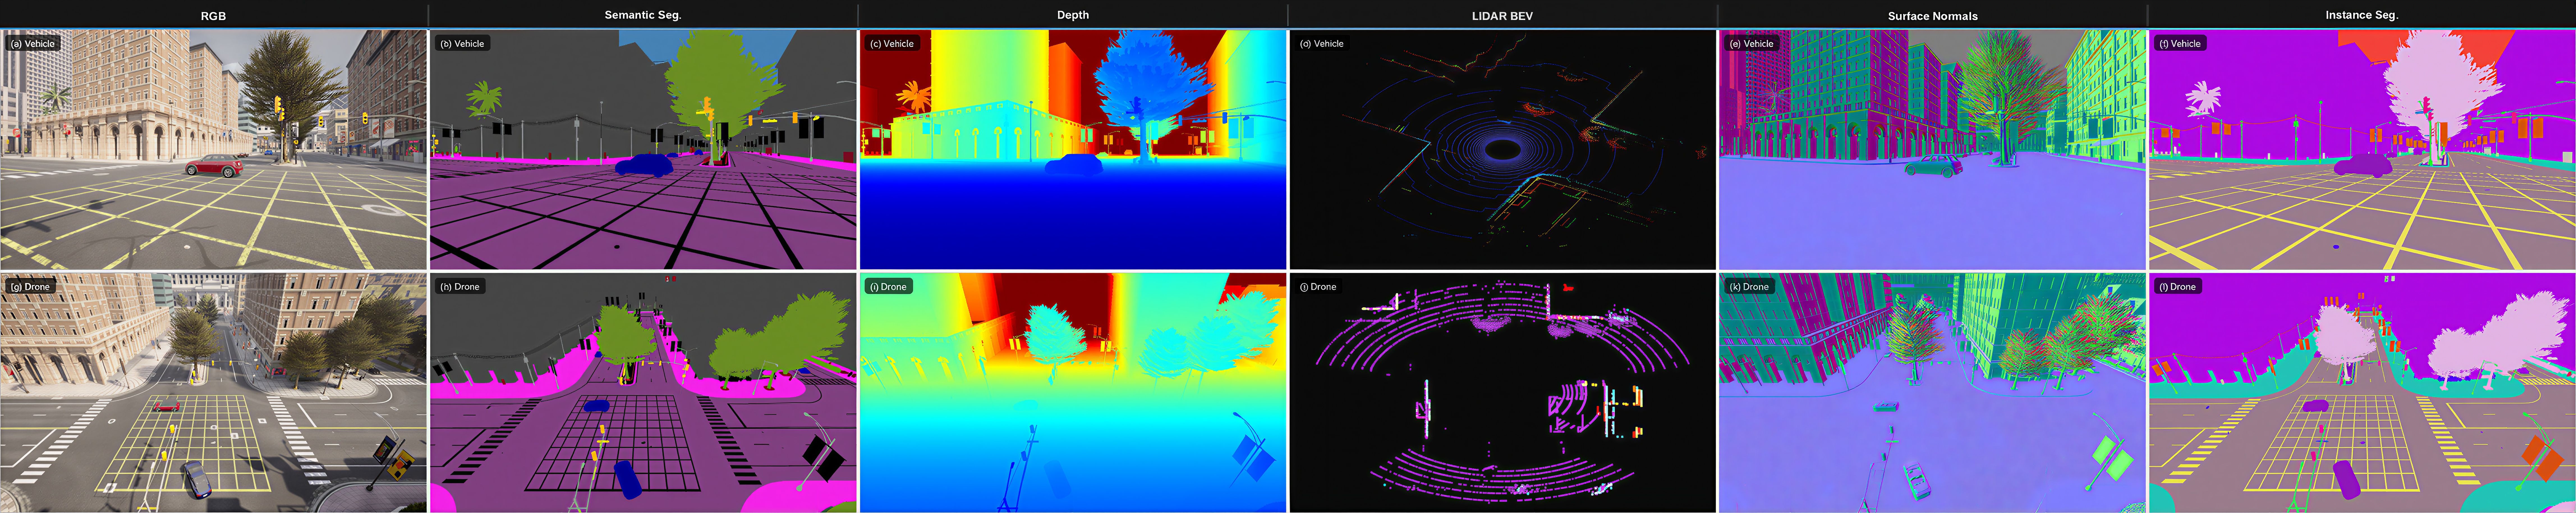
为此,我们引入了 CARLA-AIR 10——这是一个单进程的空地协同评估环境,在同一个 Unreal Engine 运行时中整合了 CARLA 和 AirSim。CARLA-AIR 保留了 CARLA 的城市交通仿真能力和 AirSim 的多旋翼动力学特性,同时将无人机(UAV)和无人地面车辆(UGV)置于统一的世界状态、物理步长(physics tick)和感知流水线之下。这种设计实现了物理一致的交互,并消除了因将 UAV 和 UGV 仿真器作为独立进程进行桥接而可能产生的仿真时间戳不匹配问题。
基于 CARLA-AIR 平台,我们评估了现有的空中 VLA(视觉-语言-动作)模型能否突破单一智能体行为的局限,实现空地协同。为此,我们设计了两项互补的诊断任务:“协同移动平台着陆”任务旨在测试针对地面伙伴的视觉追踪能否转化为协同动作;“协同遮挡恢复护航”任务则旨在测试伙伴状态线索是否有助于在发生短暂遮挡后恢复视觉接触。这两项任务分别从动作和感知两个维度考察协同能力,同时保持空中 VLA 模型的原生接口不变。
我们的研究结果揭示了空中能力与协作之间存在持续的差距。现有的空中视觉语言智能体(VLA)模型往往能够追踪或跟随无人地面车辆(UGV),但这种能力并不能可靠地转化为成功的协作行为。基于伙伴状态的提示(partner-state prompting)带来的收益有限且不稳定,而简单的双向交互甚至可能放大误差。相比之下,在具备明确的度量状态信息和低延迟协调能力的情况下,基于状态的协作参考方案表现出显著优势。这些发现表明,单架无人机(UAV)的 VLA 能力并不等同于协作;空地协作 VLA 需要具备伙伴状态建模、协作观测设计、伙伴感知动作落地(action grounding)以及团队级目标对齐等机制。
贡献:
-
闭环评估运行时环境。我们推出了 CARLA-AIR 并对其进行了验证;这是一个单进程的空地评估运行时环境,旨在统一 CARLA 和 AirSim,以支持无人机(UAV)与无人车(UGV)之间的闭环交互。通过共享世界状态、物理仿真步长(physics ticks)和感知流水线,CARLA-AIR 从机制上确保了物理一致的交互,且不存在仿真时间戳不匹配的问题。这为空地协同的闭环评估提供了可靠的基础,避免了仿真器同步误差对评估结果造成干扰。
-
诊断评估套件。我们引入了两项互补的诊断任务——移动平台着陆与遮挡恢复护航,并配套了通信协议、基准方法、基于状态的协作参考标准,以及能够区分单无人机能力与协作成功与否的评估指标。这些组件共同构成了一套针对性诊断套件,旨在隔离协作失效模式,而非对通用自主系统进行排名。
-
科学发现:在零样本评估及基于文本提示的测试方案下,现有的空中 VLA(视觉-语言-动作)模型无法自然地将单一无人机的能力迁移至空地协同场景——即追踪行为未必能转化为协同配合,来自伙伴的提示也未必能稳定触发恢复动作;对于大多数基线模型而言,这种简单的交互方式甚至可能放大错误。
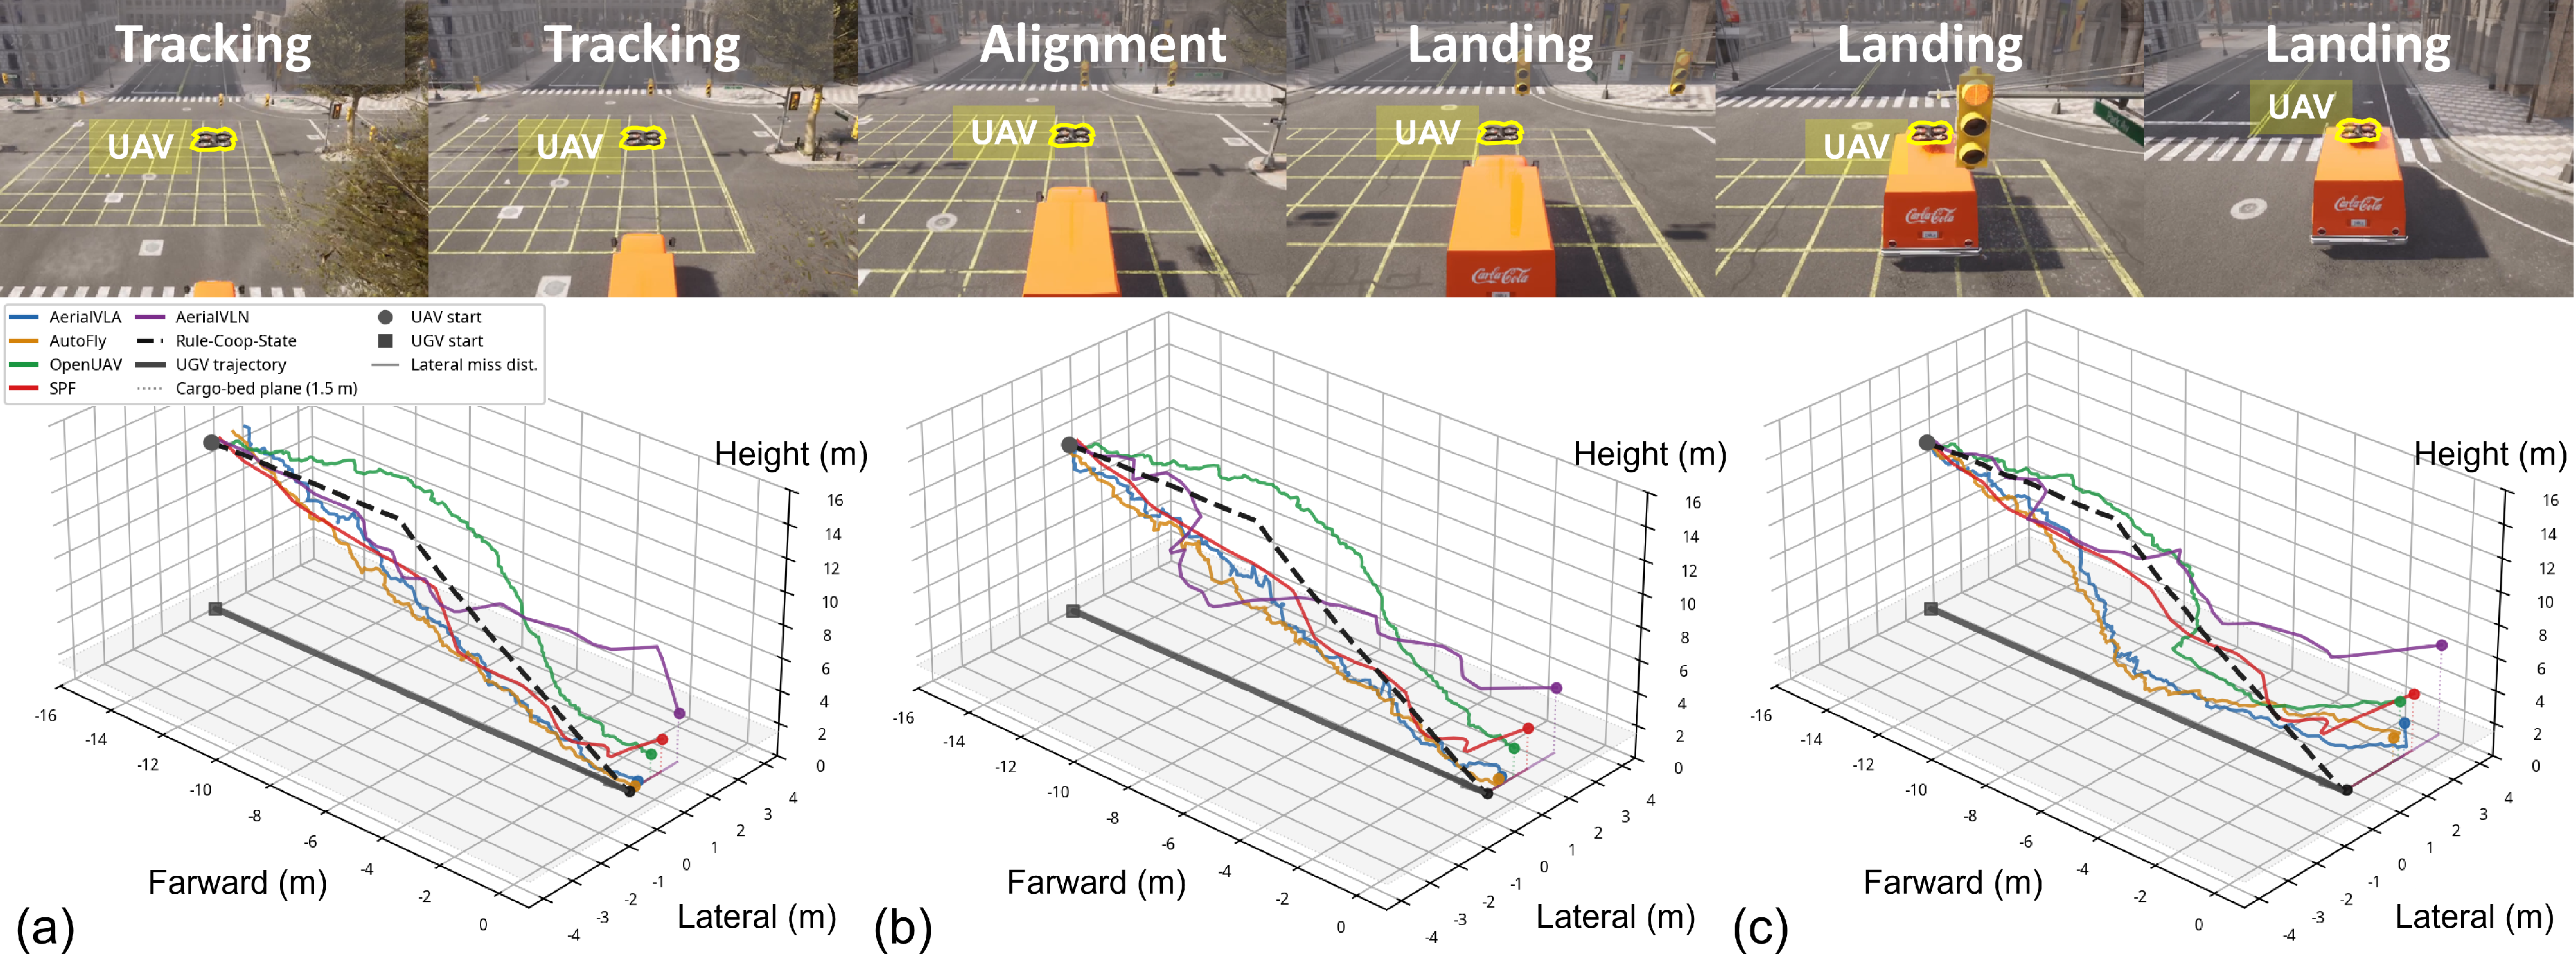
着陆过程轨迹诊断。上图:移动平台着陆期间的典型视觉序列。下图:在 (a) C0、(b) C1 和 (c) C2 工况下,移动平台着陆期间 UGV(无人地面车辆)与 UAV(无人机)的 3D 轨迹。彩色曲线表示空中基线;灰色实线表示 UGV 轨迹;黑色虚线表示 Rule-Coop-State(规则协同状态)。
诊断性评估
基于物理一致且支持闭环评估的运行环境,我们利用 CARLA-AIR 来回答本文的核心问题:现有的空中 VLA 模型能否将其在单架无人机上习得的能力迁移至空地协同行为中?
我们设计了两个互补的诊断任务。任务一“协同移动平台着陆”旨在诊断动作层面的协同能力:无人机需追踪移动中的无人地面车辆(UGV),对准其后部货箱,并安全着陆。任务二“协同遮挡恢复护航”旨在诊断感知层面的恢复能力:无人机需利用伙伴状态线索,重新建立与暂时被遮挡的UGV的视觉联系。这两项任务均保持了原生的空中视觉-语言-动作(VLA)接口不变:策略接收视觉观测和语言指令,并仅输出无人机的动作指令。
任务与协作协议
在“移动平台着陆”任务中,一辆无人地面车辆(UGV)沿城市道路行驶,其平坦的后部货厢作为着陆表面。该任务要求无人机(UAV)将可见光追踪过程转化为对移动平台的精准对齐、下降及着陆。在“遮挡恢复与伴随”任务中,UGV 会因桥梁、建筑物或大型物体而暂时被遮挡;无人机必须利用关于伴随对象状态的线索,在遮挡结束后重新建立视觉联系。
我们评估了三种协作模式。模式 C0 采用独立执行且无通信的方式。模式 C1 在 UGV 执行预定义行为的同时,引入了一种紧凑的“UGV-至-UAV 伙伴状态”提示信息。模式 C2 仅用于着陆任务,它额外将 UAV 前向速度动作信号的幅值传递给 UGV 的纵向控制器,从而实现了一种简单的 UAV 与 UGV 间的双向动作耦合。该信号源自各基准方法的原生动作接口(见附录 B)。“护航”(Escort)任务仅使用 C0 和 C1 模式。完整的提示词模板及控制器详细信息请参阅附录 B。
基线与指标
表3总结了所评估的方法,涵盖了端到端VLA、基于VLM的规划以及传统的空中VLN。各项基线方法均通过其原生的底层封装(见附录B)进行运行;所报告的数值反映了各类策略的特性,而非基于具体实现优劣的排名。
Rule-Coop-State 被纳入作为可解性参考,而非公平的基准。它利用了 VLA 基准无法获取的显式度量状态信息——包括无人机与载货平台间的相对位姿及相对速度、地面车辆(UGV)速度以及着陆阶段——并采用确定性的低延迟规则进行控制。因此,Rule-Coop-State 与 VLA 方法之间的性能差异,既反映了架构上的不同,也体现了信息获取能力的差异。我们在这一框架下解读后续的所有结果。
针对着陆任务,我们采用“追踪成功率”(Tracking Success Rate, TSR)作为单无人机基本动作的评分指标,采用“着陆成功率”(Landing Success Rate, LSR)作为最终协同任务的评分指标。我们将“协同转化率”(Cooperative Conversion Rate, CCR)定义为 CCR = LSR / max(TSR, ε)(其中 ε = 0.05),并将“协同增益”(Cooperation Gain, CG)定义为 CG() = LSR() − LSR()。针对遮挡恢复任务,我们报告“恢复成功率”(Recovery Success Rate, RSR)和“重新捕获时间”(Re-acquisition Time, RAT)。此外,我们还报告“决策频率”(Decision Frequency, DF)和“有效协同延迟”(Effective Coordination Latency, ECL)。各项指标的详细定义见附录 B。
结果
移动平台着陆。表4显示,VLA基线在C0条件下实现了可观的 TSR,但其 LSR 和 CCR 依然很低:这意味着追踪过程很少能转化为成功的协同着陆。
引入交互并不能消除这一差距。在 C1 条件下,5 个基准方案中有 4 个呈现负向 CG,但跨基准方案的趋势并不显著;而在 C2 条件下,所有 5 个基准方案均呈现负值,且趋势显著( 值分别为 0.188 和 0.031,基于符号检验)。就单个基准方案而言,AerialVLA 在两种模式下的 CG 均在统计学意义上为负,且 95% 置信区间不包含零值:CG(C1) ∈ [−0.07, −0.01],CG(C2) ∈ [−0.10, −0.04]。因此,在 C2 条件下,简单的无人机(UAV)与地面车辆(UGV)动作耦合反而导致了不稳定的协作动态,未能起到稳定任务的作用。
Rule-Coop-State 达到了 0.42 的 LSR,表明在具备显式状态基础(explicit state grounding)的情况下,该任务是可解的。图 2 展示了过程层面的分析:VLA 基线模型往往会跟随卡车,但无法平稳收敛至货厢区域;相比之下,C2 表现出较大的振荡,而 Rule-Coop-State 则实现了更稳定的下降过程。
时序因素。基于规划的重型方法决策频率较低,且有效协调延迟较大,这使得指挥控制(C2)反馈难以保持稳定(见附录 B,表 13)。然而,仅凭延迟无法解释其失效原因:即便采用 AerialVLN 等响应更快的方法,协作转化效果依然不佳。因此,性能退化既源于时序因素,也源于结构因素。
提示格式消融实验。表6显示了两项任务中一致的规律:语义、数值及含噪的提示格式均未能消除协作差距。即便是“预知型”几何提示(C1-Oracle-Bearing),也仅能带来微弱的LSR提升,且协作差距(CG)仍处于随机种子带来的变异范围内。在这种文本提示交互界面下,瓶颈在于动作落地(action grounding),而非提示的格式或完整性。
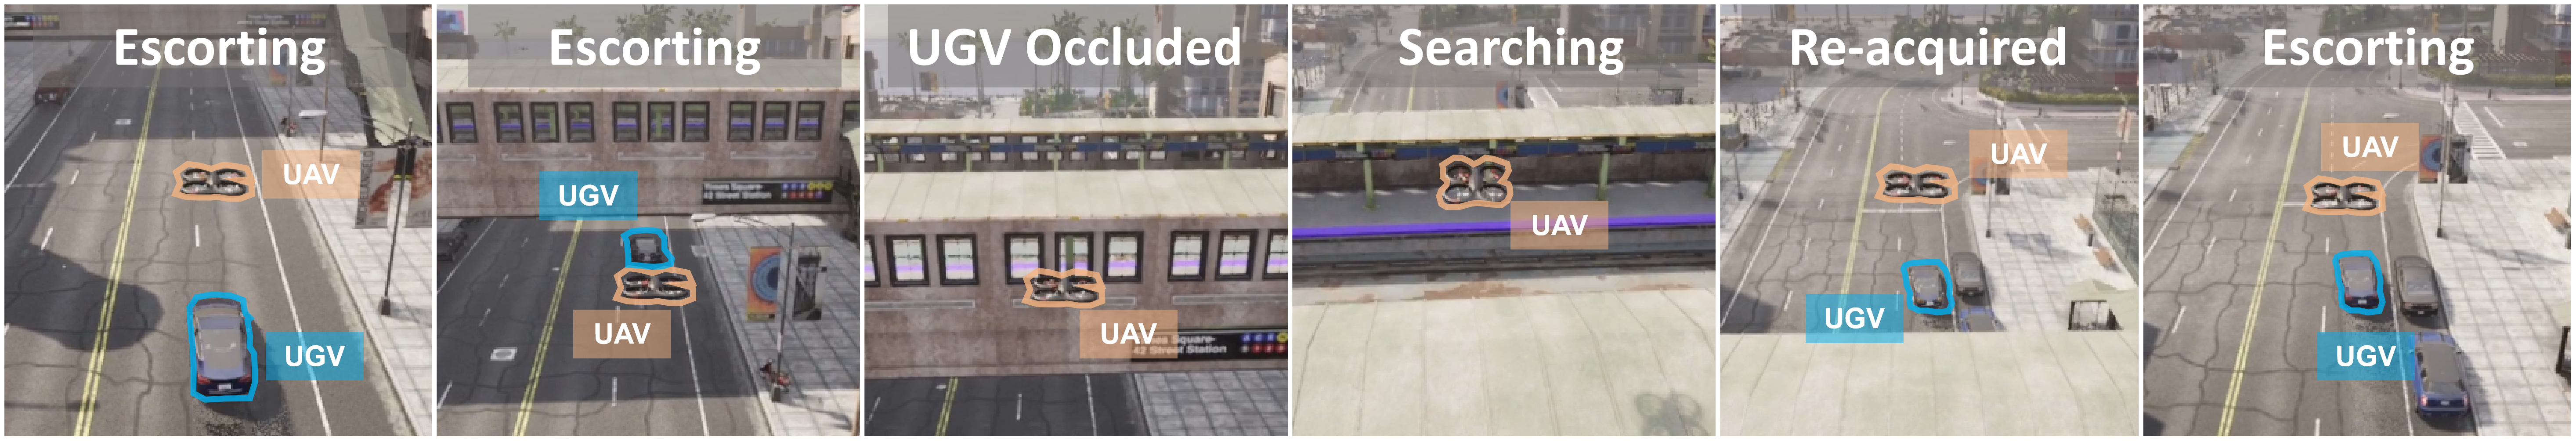
遮挡恢复。图3展示了遮挡恢复护送任务。表5显示,VLA基线模型并未始终从C1伙伴状态提示中获益;在5个基线模型中,有4个模型的C0与C1条件下的RSR差异处于随机种子(seed-level)变异范围内。SPF模型表现出显著的RSR提升(+0.08),这很可能是因为该提示(右前方)与其原生的航点输出空间相契合;而在着陆任务中,同样的提示则无法带来增益,因为着陆任务需要将该提示转化为连续下降控制指令。Rule-Coop-State模型的RSR达到了0.86。
诊断总结:在两项任务中,现有的零样本(zero-shot)空中 VLA 策略均未能将伙伴状态线索转化为协作行动——即追踪行为未能转化为协同着陆,伙伴状态线索也未能转化为恢复行动。这种失败并非源于线索的设计或完整性问题:跨基线的统计证据、提示格式消融实验以及“神谕”(oracle)方位线索均指向同一结论——缺失的机制在于自回归文本提示接口内部缺乏“具备伙伴感知能力的行动基础映射”(partner-aware action grounding)。采用显式度量状态与基于规则的协同机制的 Rule-Coop-State 方法,在两项任务中均显著优于 VLA 基线模型;这表明该性能差距源于架构设计,而非协作问题本身的根本性局限。
参考
-
Chai, R. et al. Cooperative motion planning and control for aerial-ground autonomous systems: Methods and applications. Progress in Aerospace Sciences 146, 101005 (2024). ↩
-
Zeng, T. et al. Ezreal: Enhancing zero-shot outdoor robot navigation toward distant targets under varying visibility. in 2026 IEEE international conference on robotics and automation (ICRA) 8518--8525 (IEEE, 2026). ↩
-
[Chen, H. et al.]{.nocase} Vision-and-language navigation for uavs: Progress, challenges, and a research roadmap. arXiv preprint arXiv:2604.13654 (2026). ↩
-
Zhang, Q. et al. UAV-track VLA: Embodied aerial tracking via vision-language-action models. arXiv preprint arXiv:2604.02241 (2026). ↩
-
[Gao, Y. et al.]{.nocase} Openfly: A comprehensive platform for aerial vision-language navigation. in International conference on learning representations vol. 2026 101858--101871 (2026). ↩
-
Sautenkov, O. et al. UAV-VLA: Vision-language-action system for large scale aerial mission generation. in 2025 20th ACM/IEEE international conference on human-robot interaction (HRI) 1588--1592 (IEEE, 2025). ↩
-
Liu, S. et al. Aerialvln: Vision-and-language navigation for uavs. in 2023 IEEE/CVF international conference on computer vision (ICCV) 15338--15348 (IEEE, 2023). ↩
-
Ye, H., Sunderraman, R. & Ji, S. Uav3d: A large-scale 3d perception benchmark for unmanned aerial vehicles. Advances in Neural Information Processing Systems 37, 55425--55442 (2024). ↩
-
[Wang, M. et al.]{.nocase} Transimhub: A unified air-ground simulation platform for multi-modal perception and decision-making. arXiv preprint arXiv:2510.15365 (2025). ↩
-
Zeng, T., Wen, Y. & Zhang, H. CARLA-air: Fly drones inside a CARLA world--a unified infrastructure for air-ground embodied intelligence. arXiv preprint arXiv:2603.28032 (2026). ↩