任务4:端到端策略网络(Policy Learning)
1. 模块概述
本模块用行为克隆训练一个策略网络,直接由局部观测输出速度指令,不再显式地 运行 A* 搜索:
- 输入(884 维):机器人坐标系下 21×21 局部占据栅格(2.1 m × 2.1 m)、 21×21 到目标的测地距离、目标相对位置。
- 输出(2 维):前视点在机体坐标系下的位置,再由固定控制律换算成
(v, ω)。 - 训练数据:A* 规划 + 纯跟踪生成的专家示范,占 80%;DAgger 让策略自己跑, 在它偏离后的状态上向专家重新要标签,占 20%。
与任务 3 的“地图 + A*”形成对照:任务 3 每帧都在做全局搜索,本模块把搜索的 结果压缩进网络权重,推理时只做一次前向计算。
2. 运行环境
- 操作系统:Ubuntu 22.04
- ROS 版本:ROS 2 Humble
- 依赖库:rclpy、geometry_msgs、nav_msgs、visualization_msgs、numpy(无需 GPU)
3. 编译与运行步骤
# 1. 编译
cd ~/hutb_ws
colcon build --packages-select policy_learning
source install/setup.bash

# 2. 离线跑通 采集 → 训练 → DAgger → 评测(约 6~8 分钟)
ros2 run policy_learning main

# 3. 在线演示:二维仿真 + 策略节点 + rviz
ros2 launch policy_learning main_launch.py

# 4. 另开终端发目标点
source ~/hutb_ws/install/setup.bash
ros2 topic pub --once /goal_pose geometry_msgs/msg/PoseStamped \
  "{header: {frame_id: map}, pose: {position: {x: 10.2, y: 10.2, z: 0.0}, orientation: {w: 1.0}}}"
仓库里已经带了训练好的 data/policy.npz,第 2 步可以跳过,直接做第 3 步。
4. 操作说明
- 策略节点订阅
/odom、/goal_pose,发布/cmd_vel和/plan(rviz 里看规划)。 - 仿真节点发布
/odom、/map、/robot_marker,订阅/cmd_vel,按差速底盘积分位姿, 撞墙会停住并打印警告。 rviz视图包含 Map、Path、Robot 三个显示项,固定坐标系map,俯视视角。- 离线训练的可调参数:
--episodes(专家示范段数)、--epochs、--dagger(DAgger 轮数)、--dagger-episodes。
5. 运行效果验证
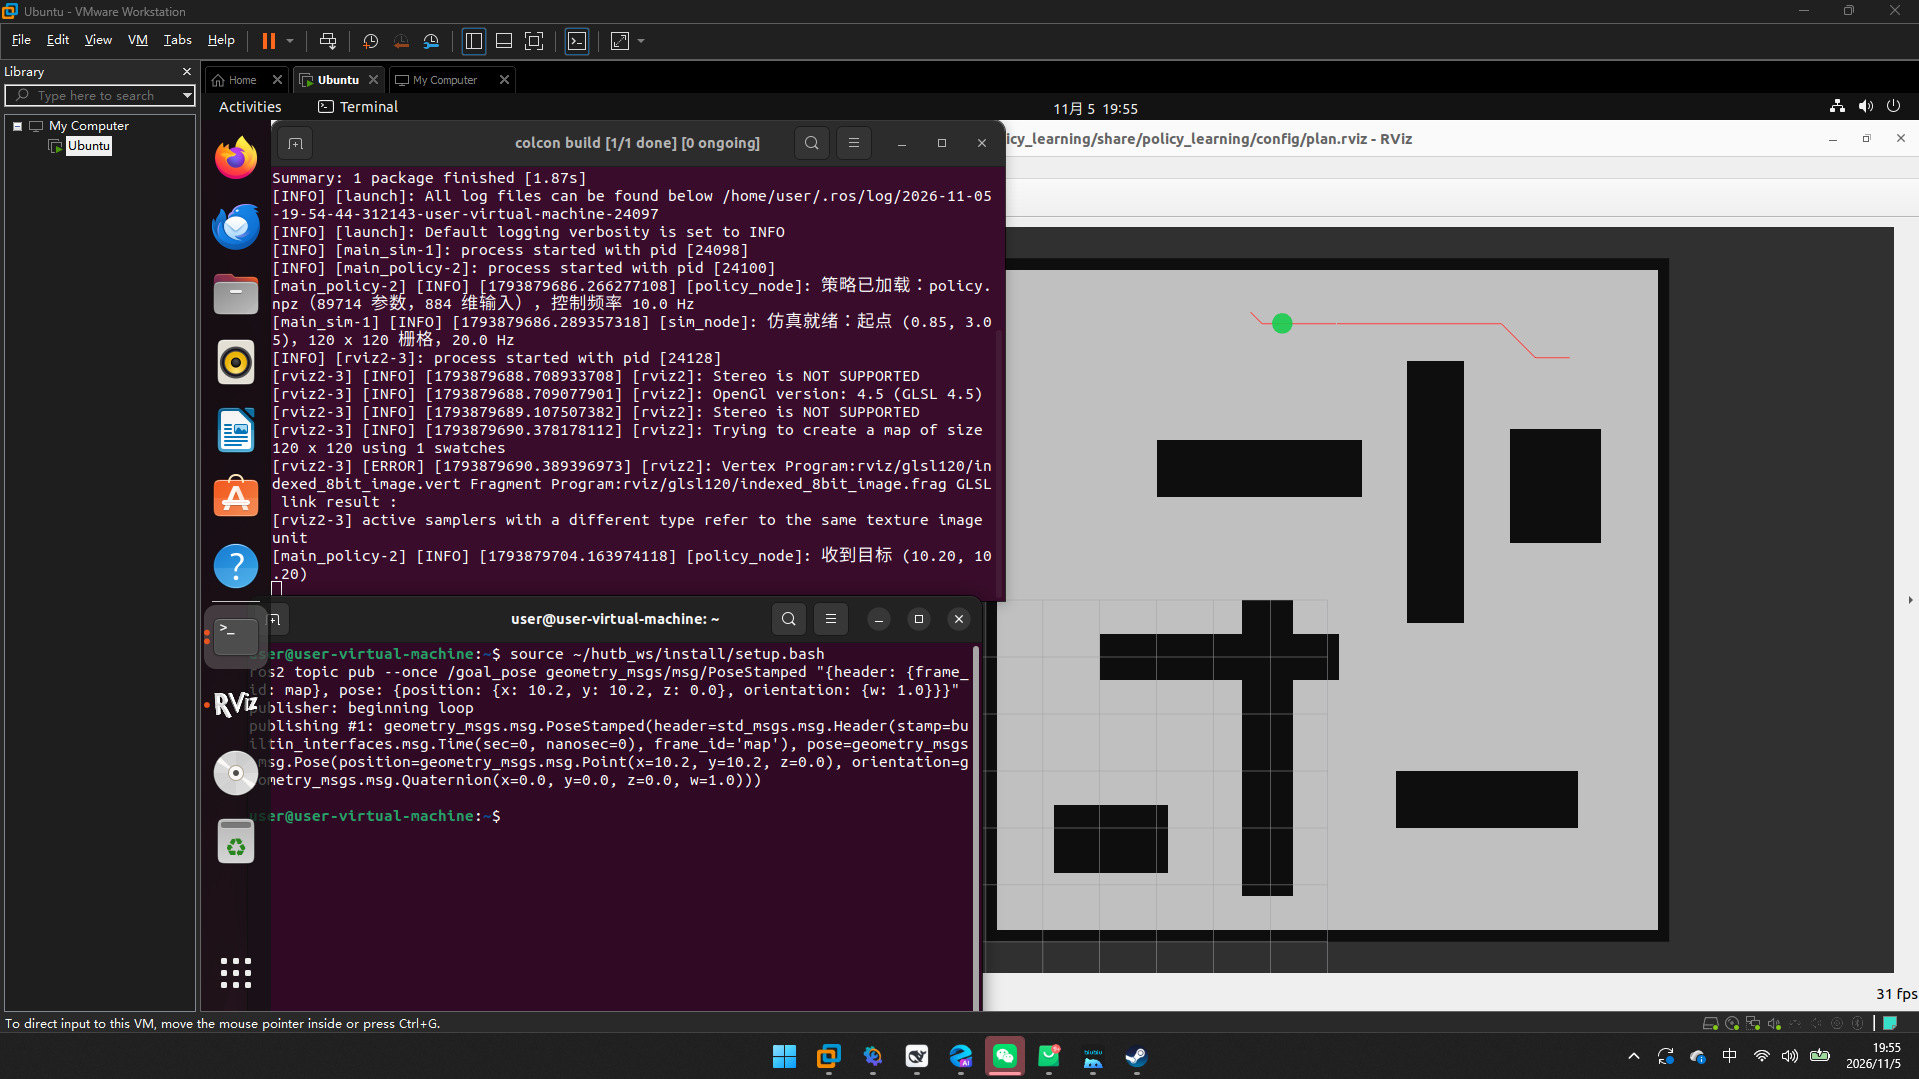
ros2 launch policy_learning main_launch.py 启动仿真与策略节点后发送目标点,
rviz 中显示占据栅格、红色规划路径与绿色机器人。
同一起点/终点集合(200 段随机任务)上的闭环结果:
| 策略 | 成功率 | 碰撞率 | 超时率 | 平均路径 | 平均步数 |
|---|---|---|---|---|---|
| 专家(A* + 纯跟踪) | 100% | 0% | 0% | 5.88 m | 86.4 |
| 策略网络 | 93.5% | 5.0% | 1.5% | 6.26 m | 100.7 |
- 回归误差(验证集 4,970 帧,前视点归一化坐标):前向 0.185、左向 0.187, 换算成距离约 0.15 m / 0.15 m。
- 推理延迟:均值 0.022 ms,P95 0.029 ms(单帧,纯 numpy)。
- 模型规模:89,714 参数,权重文件 674 KB。
- 训练数据:200 段专家示范(17,253 帧)+ 4 轮 DAgger 补充(3,418 帧),训练 200 轮(最佳第 184 轮)。
网络比专家慢约 16%:它会切一点内角,代价是路径略长、偶尔擦到障碍。这也是下面 “已知限制”的第一条来源。
6. 已知限制
- 成功率 93.5%,仍有 5% 的碰撞:网络在障碍角附近会切角,专家不会。
- 地图是固定的 12 m × 12 m 场景,网络没见过别的布局,换地图要重新采集训练。
- 运动学用二维差速模型,没有考虑加速度限制和轮子打滑。
- 观测用膨胀 6 格(0.6 m)的地图,等于把安全距离写死在感知里;真机上应改成 在线代价地图。
- 只验证仿真,没有真实机器人数据。
大模型使用声明
本模块的代码结构、调参过程与文档由作者在 AI 助手(DeepSeek)辅助下完成, 所有实验数据均在本仓库环境中实际运行产生,作者已核对并对内容负责。